OCR 文字识别
OCR 用于把图片中的文字转换成可使用的字段。当前系统提供百度 OCR 和腾讯 OCR 配置;问卷端还需要选择识别题型或上传题的 OCR 类型。
配置入口
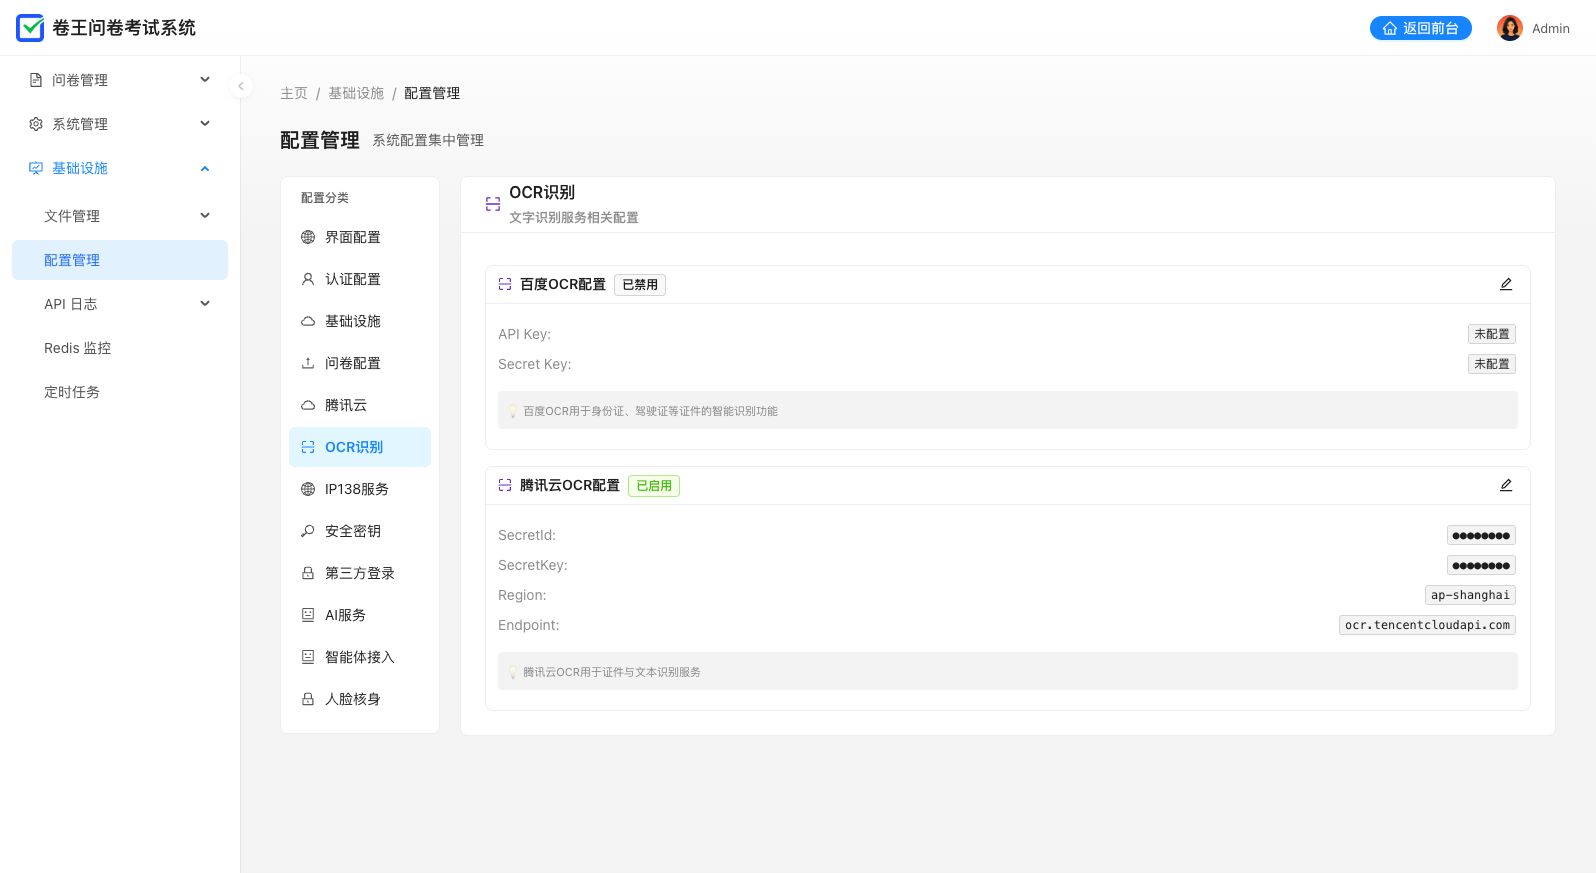
进入 基础设施 → 配置管理 → OCR 识别。
| 服务 | 需要核对的配置 |
|---|---|
| 百度 OCR | 开启状态、API Key、Secret Key |
| 腾讯 OCR | 开启状态、SecretId、SecretKey、Region、Endpoint;页面还会提示通用腾讯云凭据的使用关系 |
在服务商开通所需识别类型并取得凭据后再启用。配额、计费、权限及支持的图片规格应查阅服务商说明,例如百度 OCR和腾讯 OCR,不要按旧截图中的免费额度估算。
在问卷中使用
有两种配置方式:
- 使用编辑器提供的 图片 OCR 题(编辑器按钮为“图片 OCR”),按题目设置指定识别用途和字段。
- 为上传题设置 OCR 类型,再在接收结果的填空题中配置公式,从公式编辑器选择可引用的识别字段。
详细的字段引用与规则示例见OCR 识别与回填。先配置识别来源,再选择回填字段;普通上传题不会自动具备所有 OCR 输出字段。
验证示例
可以在独立测试问卷上传一张不含个人资料的示例图片,检查识别结果、回填值和手工修改体验。涉及身份证等资料时,应使用获准的测试样本,并明确图片会提交给所选识别服务。
识别有误时允许填写者核对,不应直接把 OCR 输出当成已经核验的真实身份。
常见问题
- 找不到可引用字段:确认题型、OCR 类型和字段设置,重新打开公式编辑器检查。
- 识别请求失败:检查配置是否启用、服务商权限、额度、图片大小与格式,并结合服务端错误排查。
- 结果为空或错误:检查图片清晰度、方向和所选识别类型,使用更清晰的样本复测。